Chuyển file SRT thành giọng nói: tạo MP3 đúng nhịp
SRT có sẵn lời và thời gian. Việc khó là chọn cách đọc giữ timeline, phát hiện câu quá dài và kiểm tra MP3 trước khi ghép video.
Để chuyển file SRT thành giọng nói, phần mềm phải đọc được từng cue gồm thời gian bắt đầu, thời gian kết thúc và câu thoại. Sau đó nó tạo tiếng cho từng cue, chèn khoảng im lặng và ghép thành MP3. Bản Pro và ElevenLabs của Tofu Voice nhận SRT và VTT; Base không nhận hai định dạng này.
Kiểm tra SRT trước khi tạo audio
Một cue SRT thường có số thứ tự, dòng thời gian như `00:00:03,000 --> 00:00:06,500`, rồi đến câu cần đọc. File có thể thiếu dòng trống cuối, nhưng phải có ít nhất một timing hợp lệ và nội dung có thể đọc.
- Mở file bằng trình soạn thảo và xác nhận tiếng Việt không bị mất dấu.
- Xóa mô tả không cần đọc như nhạc nền hoặc hiệu ứng nếu chúng đang nằm trong câu thoại.
- Tách một câu quá dài thành hai cue khi thời lượng trên video quá ngắn.
- Giữ một bản SRT gốc trước khi sửa câu hoặc mốc thời gian.
Giữ timeline hay đọc liền thành một bài
Với giọng Edge, CapCut, offline hoặc clone local, Tofu Voice đọc từng cue và chèn im lặng để câu bắt đầu theo timeline. File cuối được kéo đến mốc kết thúc cue cuối. Nếu một câu đọc dài qua mốc bắt đầu kế tiếp, câu sau sẽ bắt đầu khi câu trước kết thúc; phần mềm không thể ép lời nói chồng lên nhau hoặc tự cắt mất tiếng.
Nếu chọn family ElevenLabs, app ghép nội dung các cue thành đoạn đọc liên tục và bỏ timing. Cách này hợp với việc lấy nội dung phụ đề làm podcast hoặc audio liền mạch, nhưng không phù hợp khi MP3 phải khớp hình từng câu.
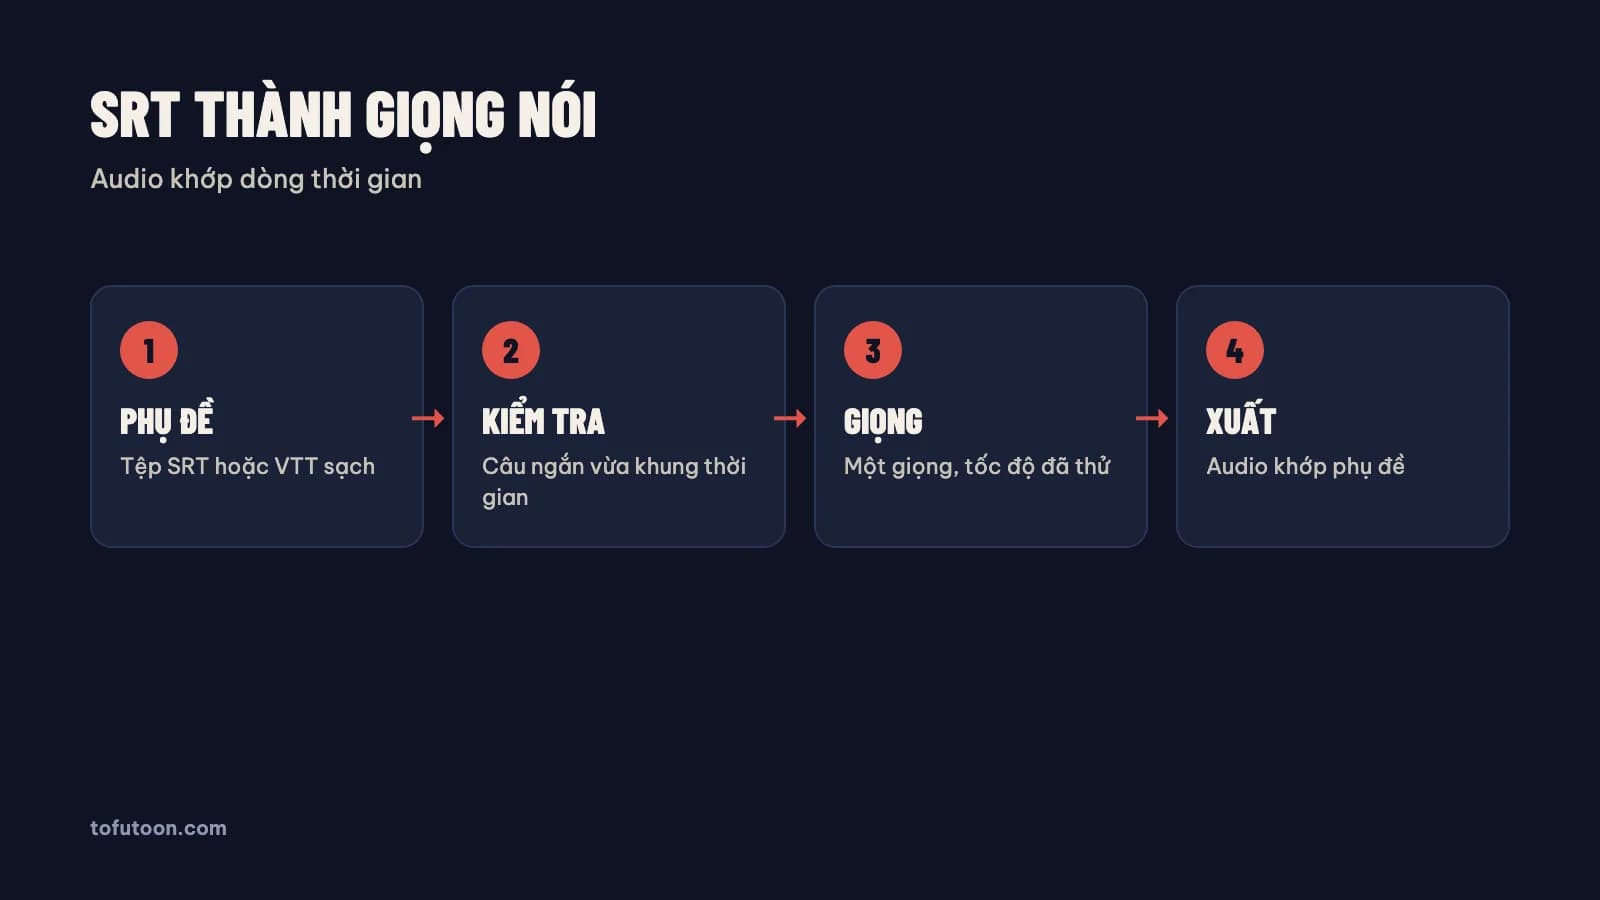
Quy trình tạo MP3 từ SRT hoặc VTT
- Chọn file SRT/VTT hoặc dán nguyên nội dung phụ đề vào Tofu Voice.
- Đọc phần preview: số cue, tổng thời lượng và file nguồn phải đúng.
- Chọn giọng tiếng Việt và tạo thử một đoạn có câu ngắn lẫn câu dài.
- Nghe xem câu có bắt đầu đúng lúc và có bị tràn sang cue kế tiếp không.
- Rút gọn câu, tách cue hoặc đổi tốc độ khi lời dài hơn thời gian cho phép.
- Chọn thư mục output, tạo MP3 hoàn chỉnh rồi ghép thử vào video trước khi xuất bản.
Nếu chưa chọn được voice, dùng câu kiểm thử trong bài text to speech tiếng Việt. Nếu cần xử lý cả thư mục nguồn, xem cách đặt tên và resume trong bài tạo audio nhiều file TXT; nguyên tắc giữ source/output riêng vẫn áp dụng.
Vì sao audio bị lệch phụ đề
Câu thoại dài hơn cue
Một câu 20 từ trong cue hai giây gần như chắc chắn bị tràn. Rút gọn lời dịch, tăng thời lượng cue hoặc tách thành hai cue. Tăng tốc quá mạnh có thể làm tiếng Việt khó nghe, nên luôn nghe bản thử.
File SRT sai định dạng
Sai dấu phẩy ở milliseconds, thiếu mũi tên `-->`, timing đảo ngược hoặc file không còn cue nào đều có thể làm parser từ chối. Sửa trên bản sao rồi mở lại preview.
Chọn nhầm cách đọc ElevenLabs
Family ElevenLabs chủ động bỏ timing để tránh tạo từng cue qua hàng đợi. Nếu mục tiêu là lồng tiếng bám video, hãy chọn một family voice hỗ trợ đường timed.
Checklist trước khi ghép vào video
- MP3 bắt đầu đúng mốc cue đầu và có tổng thời lượng gần timeline dự kiến.
- Tên riêng, số và chữ viết tắt được đọc đúng trong các cue khó.
- Không có câu bị cắt; cue dài đã được sửa thay vì chỉ tăng tốc toàn bộ.
- SRT gốc, bản đã sửa và MP3 nằm ở các file riêng để có thể quay lại.
Câu hỏi thường gặp
Có thể chuyển VTT thành giọng nói giống SRT không?
Có. Tofu Voice Pro và edition ElevenLabs nhận cả SRT và VTT. App đọc cue và thời gian của từng định dạng trước khi tạo audio.
MP3 có tự khớp video tuyệt đối không?
App chèn im lặng để bám mốc bắt đầu, nhưng không thể ép một câu nói dài vào cue quá ngắn. Bạn vẫn cần kiểm tra và sửa các cue bị tràn.
Bản Base có đọc SRT không?
Không. Base nhận TXT. SRT và VTT thuộc Pro và edition ElevenLabs.
Dùng ElevenLabs có giữ timing SRT không?
Không khi bạn chọn family ElevenLabs. Nội dung cue được đọc liền thành một MP3. Trong edition EL, hãy chọn một family timed khác nếu cần bám timeline.